Ремонт серверов Dell PowerEdge и HP ProLiant в Москве
Диагностика серверного оборудования: от блоков питания до RAID-контроллеров. Когда чинить, а когда менять.
Типовые отказы серверов
При аварии Dell PowerEdge или HP ProLiant важно сохранить признаки, по которым можно восстановить последовательность событий. Запишите модель и Service Tag или серийный номер, время отказа, состояние индикаторов и сообщение на экране. Если система управления доступна, сохраните журнал iDRAC или iLO до очистки и изменения конфигурации. Не сбрасывайте контроллер, не обновляйте прошивку и не отключайте компоненты наугад: такие действия способны убрать контекст ошибки и усложнить диагностику. Если сервер ещё работает, сообщите, какие службы и диски доступны и были ли перед сбоем изменения питания, нагрузки или оборудования. Не повторяйте многократные циклы включения, если слышны необычные звуки, появился запах перегрева или оборудование самопроизвольно отключается.
Нет питания, POST или загрузки
Одинаковый симптом «сервер не включается» может быть связан с внешним электропитанием, блоком питания, платой, памятью, картой расширения или остановкой POST. По одному индикатору нельзя надёжно определить неисправный модуль. Для PowerEdge полезны сообщения POST и Lifecycle Log в iDRAC; для ProLiant — сообщения POST и Integrated Management Log в iLO. Если управляющий интерфейс доступен, сохраните относящиеся к отказу записи и версию платформы. Отдельно укажите, запускаются ли вентиляторы, меняется ли состояние индикатора питания и видит ли сервер контроллер управления. Дальше проверку выбирают по точной модели и её документации: процедуры разных поколений могут отличаться. Не извлекайте блоки, карты или память из включённого устройства, если для конкретной системы это не предусмотрено руководством.
RAID, диски и риск потери данных
Ошибки дисков, контроллера и массива требуют особенно осторожного порядка действий. Сфотографируйте сообщения при загрузке и запишите, какие индикаторы горят на носителях, но не меняйте диски местами и не запускайте принудительную инициализацию. Rebuild массива не является универсальным способом исправить сбой: при нескольких проблемных накопителях или неверной последовательности он может усложнить восстановление. Перед работами администратор должен определить состояние резервной копии и допустимость остановки сервера. При передаче сообщите конфигурацию RAID, модель контроллера, число установленных дисков и последние изменения, если эти данные известны. Производственные данные нельзя использовать как тестовый материал без отдельного согласования. Задача аппаратной диагностики — установить неисправность и согласованный способ проверки, а не обещать восстановление информации, которое требует отдельного процесса и оценки носителей.
Память, перегрев и нестабильная работа
Ошибки ECC, внезапные перезагрузки и снижение производительности могут иметь разные причины: модуль памяти, слот, процессор, питание, охлаждение, прошивка или программная нагрузка. Важны точный код события, повторяемость и условия проявления. Для перегрева полезно сообщить, менялась ли скорость вентиляторов, повышалась ли температура в стойке и было ли обслуживание перед отказом. Не очищайте журналы и не заменяйте сразу все модули: при диагностике важно сохранить возможность локализовать сбой. Проверку памяти и температур согласуют с администратором с учётом установленной ОС и режима работы. Если ошибка появляется только под нагрузкой, лабораторный тест без рабочей конфигурации может её не воспроизвести; это ограничение фиксируют в результате, а не скрывают за общим словом «исправно».
iDRAC и iLO: какие материалы ускорят диагностику
Вместе с заявкой можно передать выгрузку системных журналов и отчёта платформы, если это разрешено политиками вашей организации. Для PowerEdge это могут быть Lifecycle Log и SupportAssist Collection из iDRAC; для ProLiant — Integrated Management Log и Active Health System Log из iLO. Набор доступных отчётов зависит от поколения, лицензии и состояния сервера. Перед отправкой проверьте, не содержит ли файл адреса, имена пользователей, сетевые настройки или другие внутренние сведения, которые нельзя передавать внешнему подрядчику. Не присылайте пароль администратора и не открывайте удалённый доступ без утверждённого вашей организацией порядка. Полезны также модель, Service Tag, конфигурация, точное время отказа, сообщение POST и краткая история последних изменений. Эти данные помогают определить состав работ, но не заменяют физическую проверку неисправного узла.
Стендовая проверка
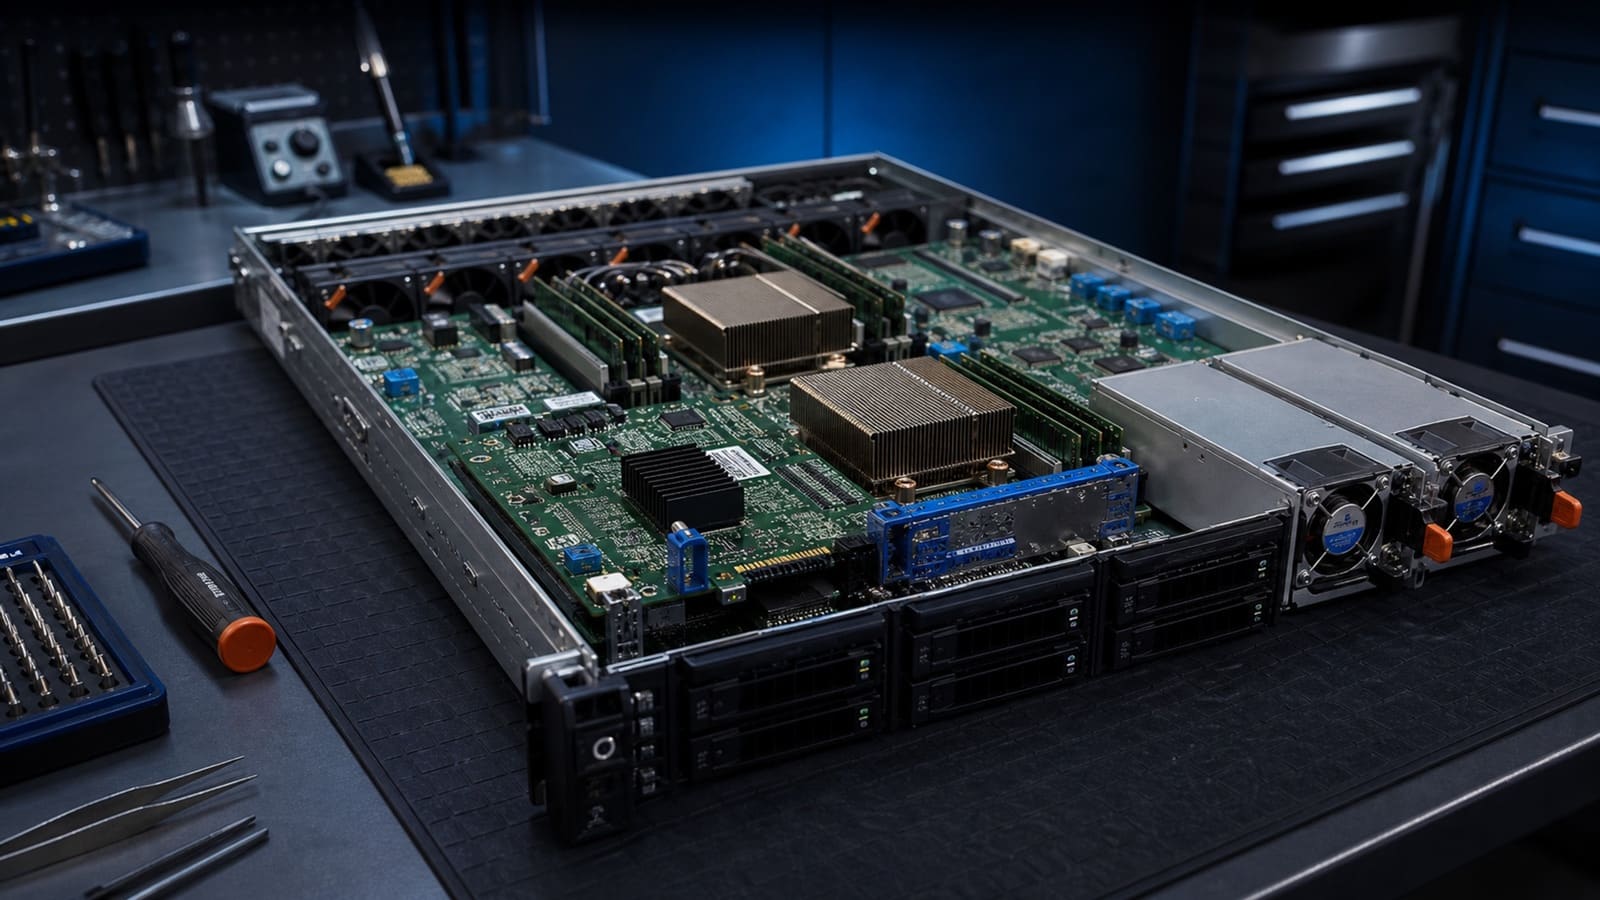
До начала работ фиксируем исходный симптом и согласуем, какие узлы и режимы можно проверять. Состав испытаний зависит от модели, комплектации, доступных запасных частей и того, можно ли воспроизвести рабочую нагрузку вне стойки. При необходимости отдельно согласуют проверку блока питания, платы, памяти или контроллера; это не означает, что любой сервер проходит один и тот же универсальный тест. Установка и производственная сеть заказчика не используются для диагностики без явного согласования. После ремонта проверяют затронутый узел, доступные журналы и те функции, которые были определены в заказе. Если часть нагрузки нельзя безопасно воспроизвести в мастерской, это указывают как ограничение результата. Для возврата сервера в эксплуатацию администратор заказчика планирует подключение к сети, запуск служб и контроль данных.
Ремонт vs замена
Решение сравнивают не по цене детали отдельно, а по совместимости и полным затратам. Для замены нужно подтвердить точное исполнение, ревизию, поддержку сервером, наличие и срок поставки. Для ремонта — установить характер дефекта, стоимость деталей и работ, проверяемые параметры и гарантийные условия. Блок питания, вентилятор, плата управления и RAID-контроллер имеют разные критерии проверки; подмена похожей моделью может быть несовместима по разъёмам, прошивке или мощности. Если неисправность затрагивает критичные данные, сокет, многослойную плату или несколько узлов одновременно, до ремонта обсуждают риски и пределы результата. Клиент получает основание для выбора до выполнения несогласованных работ. Без модели, ревизии и результатов диагностики обещать фиксированную стоимость или одинаковый срок для всех серверов некорректно.
Как подготовить сервер к передаче в сервис в Москве
Перед обращением укажите производителя, модель, серийный номер, симптомы, сообщение на экране и срочность восстановления. Для стойкового сервера приложите сведения о высоте и весе, дисках, рейках и комплектности; способ доставки и приёма крупного оборудования согласуйте заранее. Отдельно назначьте технического контактного лица, которое знает допустимое время отключения и порядок доступа. До передачи проверьте наличие резервной копии средствами вашей организации и обозначьте носители, которые нельзя включать или перемещать. Сетевые кабели, пароли и конфигурационные файлы передавайте только если это действительно нужно и разрешено внутренними правилами. На приёме полезно сверить маркировку и комплектность, а в заказе зафиксировать заявленный симптом, согласованные проверки и ограничения. Это снижает риск недопонимания между сервисом и администратором.
Короткий чек-лист
- сохранить точную модель, Service Tag и сообщение POST
- экспортировать доступные журналы iDRAC/iLO до очистки
- проверить резервные копии и согласовать останов сервера
- передать конфигурацию RAID и историю изменений, если известны
- согласовать тесты, сроки, стоимость и ограничения до ремонта
Частые вопросы
Можно ли назвать цену ремонта сервера по телефону?
По симптомам можно определить направление диагностики, но точную стоимость зависит от модели, ревизии, найденного узла и доступности совместимой детали. Состав и цену работ согласуем после проверки.
Нужно ли привозить диски вместе с сервером?
Это зависит от неисправности и внутренней политики заказчика. Не перемещайте накопители и не меняйте их местами без согласования с системным администратором; заранее сообщите, если диски содержат рабочие данные.
Можно ли проверить сервер под рабочей нагрузкой?
Только если условия и доступ к нагрузке согласованы. Стендовая проверка может не воспроизвести сбой, зависящий от сети, программ или конфигурации заказчика; такие ограничения указываются в результате диагностики.